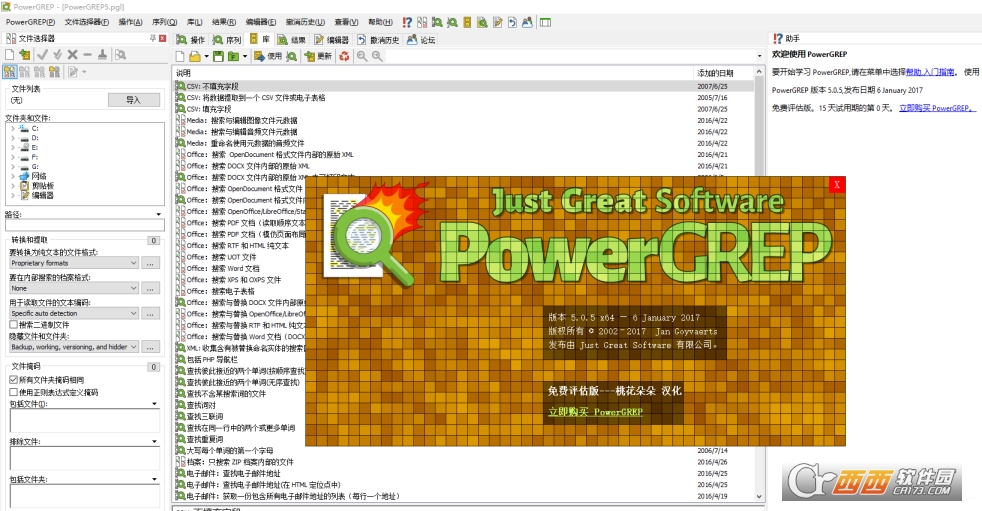
PowerGREP汉化版是一款功能强大的正则表达式应用软件,这款软件不只拥有检索功能,还拥有数据编辑、替换与数据采集等功能。其中,检索功能可用于词语搭配研究、类联接研究;数据编辑、替换与采集功能可用于语料库的加工与处置。
1.1 信息检索
信息检索是语料库研究中最容易见到的方法之一。借助PowerGREP进行检索,其检索办法主要为文本检索和正则表达式检索,前者比较直观、易学,但功能比较单一,可用于一些简单的检索;而后者的学会需要肯定时间的学习,但功能强大,可用于大型的检索。
选择主界面中的动作标签,在概念操作种类栏的下拉菜单中选择显示搜索匹配,并在概念搜索种类栏的下拉菜单中选择普通文本或正则表达式。搜索种类默觉得正则表达式,假如搜索关键词为普通检索词,软件会自动辨别。不一样的操作种类与文本种类的确定会显示不一样的选项供大家选择,如不同大小写、大小写自适应等。在搜索框中输入检索词或正则表达式,点击搜索即可完成检索。
2.2 编辑与替换
在进行语料剖析时,研究者们有时需要对语料库中的语料或标重视新进行加工,如删除、替换或添加标注等。大家可以用PowerGREP的编辑与替换功能来批量完成这类任务。只须在概念操作种类栏的下拉菜单中选择搜索与替换,并在概念搜索种类栏的下拉菜单中选择普通文本或正则表达式,然后在搜索框与替换框上分别输入被替换词与替换词,点击替换按钮即可完成文本信息的替换。其编辑功能主要通过内置的编辑器达成,使用方法像Windows系统自带的记事本,这里不再介绍。
2.3 数据采集
采集功能是PowerGREP的又一特点,它的作用是将所有匹配检索词所在的句子保存为一个或多个文件,便捷研究者依据我们的研究目的或需要对语料进行重新赋码。在概念操作种类栏的下拉菜单中选择采集数据,并在概念搜索种类栏的下拉菜单中选择普通文本或正则表达式。然后,在文件地区的下拉菜单中选择逐行,并勾选采集或替换所有匹配地区,这么做的目的是保证采集结束后所有些匹配结果将以逐行的形式提取并可保存为一个文件。接着,设置保存的文件名、文件种类与路径。最后在检索框输入检索词并点击采集,完成数据的采集工作。
2 正则表达式简述
所谓正则表达式,就是用某种模式去匹配一类字符串的公式。它由一些普通字符和11个元字符组成。普通字符包含大小写的字母和数字,而元字符则具备特殊的意思。比如,汉语“灰色”在英语中可以写为gray或grey。假如大家用一般文本检索的话,需要将gray和grey分两次填入搜索框并进行两次检索。但假如用正则表达式,大家仅需选择搜索种类为正则表达式,然后在搜索框中一次输入gr[ae]y就能了。其中的方括号就是一个正则表达式,表示匹配方括号中a和e任意一个字符。大家于表1中列出了所有11个元字符,并逐一进行讲解。
在语料库语言学研究中,大家需要学会一些基本的字符组合,即元字符和普通字符的组合。\d代表 [0|9],即0到9之间任意一个数字; \w代表[A|Za|z],即A到Z或a到z之间任意一个字母;\s代表“空白字符”,包含空格符、制表符、回车符或换行符。假如将这三个正则表达式中的普通字符由小写改为大写,正则表达式的意思恰恰相反。\D表示[^\d],即非0到9之间任意一个数字;\W表示[^\w] ,即非A到Z或a到z之间任意一个字符;\S表示 [^\d],即非空格符、制表符、回车符、换行符。值得注意的是,假如将这类表示否定的字符组合放在方括号内,其意义将发生变化。比如,正则表达式[\D\S] 的意思为非数字或者非空格符、制表符、回车符、换行符。换言之,它可以匹配任意一个字符,包含数字、空格符、制表符、回车符、换行符和字母。而表达式[\s\d]的意思为既非数字,也非空格符、制表符、回车符或换行符,即该表达式匹配任意一个字母。
在进行语料库检索中,大家还需要知道一些常用字符组合。\b 匹配单词的前或后边界。比如,\bray\b只能匹配ray这个单词,如此做像文本检索中的whole words only ray,而ray\b则可以匹配以字母ray结束的单词,如gray或者ray 中的ray,但不可以匹配 rayage中的ray。这个表达式尤为重要,在语料库研究中大家可以用tion\b来检索以tion为后缀的所有单词,也可以用\bpre这个表达式来检索所有以pre为前缀的单词。又如,\A表示文件的开始。除此之外,在语料库文本处置时还会用到三个不可显示的或非打印的特殊字符\r,\t和\n,它们分别代表回车符,制表符和换行符。
在用正则表达式的过程中,知道以上提及的字符与字符组合,大家还应该注意优先级顺序。像数学表达式求值,正则表达式是从左至右按优先级顺序来描述一个字符串的。下表由高到低列出了各种正则表达式操作符的优先级顺序:3 PowerGREP在语料库加工中的应用
语料库一般分为标注语料库与非标注语料库或生语料库。语料库语言学研究中尤为重要的一环就是对语料库中的标注进行添加、删除或修改。语料库标注不只包含词性标注,还包含句法标注、语义标注、话语标注和语用标注等。但,现有些语料库标注主要为词性标注,而因为其他形式的标注智能化赋码比较很难达成,一般采取人工标注,并仅限于一些小型语料库。)。因此,依据不一样的研究需要,大多时候语料库研究者需要对现有些语料库进行加工与处置。现在可以用于语料库赋码处置的软件为数不多,PowerGrep则是其中的一名佼佼者。本文重点举例说明PowerGrep对BNC语料库标注进行删除、添加和修改的应用。
3.1 删除语料标注
假设大家要调查中国大学生记叙文中单词so的用法状况,使用《中国学生英语口笔语语料库》和《英国国家语料库》进行对比研究。本研究需要根据so的话语功能分类进行标注,而后者的语料已进行过词性赋码,因此,大家需要先删除其原始词性标注。
在正式删除词性标注前,大家有必要认识一下BNC的标注特点。BNC的标注一般放在一对尖括号内,具体的标注说明可以参照BNC2 POS|Tagging Guide和Users Reference Guide British National Corpus,这里仅补充他们没提及但大家需要熟知和知道的一些标注:① BNC的文件头标注既包含尖括号内容,也包含普通文本,只有将之删除才能确保研究者进行词数统计的精准性;② 标注中的s代表句子,n=“1”代表第一行;③ 尖括号内的所有单词的词性标注都是以字母w开始的,其中,w代表单词word;④ 标点符号除双引号外均以字母c开始;⑤ bquo;代表直接引语开始时的双引号,equo;代表直接引语结束时的双引号。鉴于以上BNC的词性标注特点,大家将删除工作分为四步。
删除文件头
用PowerGREP自带的编辑器打开选取的文件。BNC中标志正式文本语料开始的第一行,此前是对该文本的说明,即文件头。因此,大家在文本中定位到,然后删除之前的文件头部分。
替换bquo;与equo;为双引号。
第一在概念操作种类栏的下拉菜单中选择搜索与替换,并在搜索种类栏的下拉菜单中选择正则表达式。然后,在搜索栏中输入bquo;替换栏中输入双引号,点击替换按钮,将bquo;替换成双引号。接着,大家采取同样的办法将equo;也替换成双引号。
替换等行号为空格。
在搜索栏输入正则表达式,将光标插入替换栏,敲击两下空格键,如此做的目的是为了维持原文的格式,即首行缩进两个字符。接着,点击替换按钮,完成语料中以s开头的行号标注的删除工作。
删除其余所有标注。
在搜索栏中输入正则表达式,替换栏留空,然后点击替换按钮,完成其余他所有标注的删除。大家用编辑器查询最后的编辑成效。如图3所示,一个干净可读的文本展示在大家面前,将之直接保存即可。
3.2 添加语料标注
删除去BNC语料中的标注之后,下面大家就能按单词so的话语功能对中国学习者语料和BNC语料重新进行标注。大家需要先采集所有包括单词so的句子,然后借助PowerGREP的编辑器功能进行人工赋码。
采集
如图4所示,大家第一选择在概念操作种类栏的下拉菜单中选择采集,并在搜索种类栏的下拉菜单中选择正则表达式。然后,勾选Group results for all files与Group identical matches两个选项,并在搜索栏中输入检索词so的正则表达式\bso\b。接着,在文件地区的下拉菜单中选择逐行,并勾选采集或替换所有匹配地区,如此保证采集结束后所有些匹配结果将以逐行的形式提取并可保存为一个文件。在采集之前还需预先设置文件保存的种类和路径。因此,大家在创建目的文件中选择将结果保存为单个文件,然后在目的文件地址处填入保存文件名与路径,如D:\我的文挡\so.txt。最后,点击采集按钮即可得到所有包括单词so的句子。
标注
大家用PowerGREP自带的编辑器打开刚刚采集并保存的文档。如图5所示,每行都只有一个单词so,如此既便捷了赋码操作,又节省了大家研究者的时间。限于篇幅,具体的赋码过程在此不一一叙述。BNC语料赋码结束后,大家重复以上步骤对SWECCL进行标注,如此就完成了单词so研究剖析前的标注工作。
3.3 修改语料标注
PowerGREP还可用来修改语料标注。语料标注的修改大致出于两种缘由:标注调整和赋码纠正。
内容搜索图片,
在本抓图中,我搜索了c:/My Documents/My Web Sites文件夹及其子目录下所有些html文件。我用了一条正则表达式把搜索范围限定在HTML tag之内,用另一条正则式在这类标记中搜索所有些email地址。
搜索和替换
一个好使的功能是可以预览结果而不是立即替换。匹配结果以黄色标出。双击匹配就能打开对应的文档并检验其内容。
点击实行后,颜色改变,表示已经推行替换。
采集信息和统计数据,
本例是“测试Apache互联网日志--谷歌 search terms”的例子。本例用的正则式在PowerGREP帮助文档中有详细解说。
灵活的“撤消”历史记录,叫你不再抓狂,
在实行替换的同时,PowerGREP已经备份了原文件。只须你没手工删除这类备份的文件,你可以随意撤消你做过的任何操作。世界上真有后悔药的呀。
搜索PDF文档,
PDF也能用正则式进行搜索?当然了,你没看错。只不过,要确保PDF文档中你要搜索的内容是文字而非图像。也就是说,扫描版的PDF不享受此功能的哟。
在MS word 文档中搜索,
这个功能也十分有用。我记得还有个东东叫ViEmu for Word Outlook,可以在word和outlook中模拟vim,当然可以用正则式搜索替换了。不过,ViEmu一来也是收银管理系统(在2008年5月31日之前是79美刀,之后是99美刀),我还没找到免费版本;二来其正则式是vim风格的,只习惯Perl风格的同学可能不太习惯。在谷歌 documents里也支持正则式搜索了,具体语法、风格尚未广泛测试。
在MS Excel中搜索,
同样也是批量搜索、替换。不单单是对一个文档、一个sheet。
以16进制模式,在2进制文档中搜索,
跟二进制编辑器界面类似,多了正则式批量搜索替换功能。
在zip压缩文档中搜索,
把zip文件当作普通文件夹来搜索。非常强大吧?
正则表达式序列
大部分正则式工具一次只支持一条正则式的操作。而PowerGREP可以一次实行多条正则式!用checkbox来进行多项选择。
TAG标签:正则表达式(2)PowerGREP(1)
转载请说明来源于当下软件园(https://www.gpsdan.com)
本文地址:https://www.gpsdan.com/soft/12850.html
郑重声明:文章来源于网络作为参考,本站仅用于分享不存储任何下载资源,如果网站中图片和文字侵犯了您的版权,请联系我们处理!邮箱3450399331@qq.com
声明:当下软件园为非盈利性网站 不接受任何赞助和广告
Copyright2007-2022 当下软件园(https://www.gpsdan.com).All Rights Reserved
备案编号:赣ICP备20001389号 赣公网安备 36010602000087号